データマイニング・予測分析ソフトウェア
IBM SPSS Modeler
ノードをつなぐ操作で、予測モデルを業務の中へ。
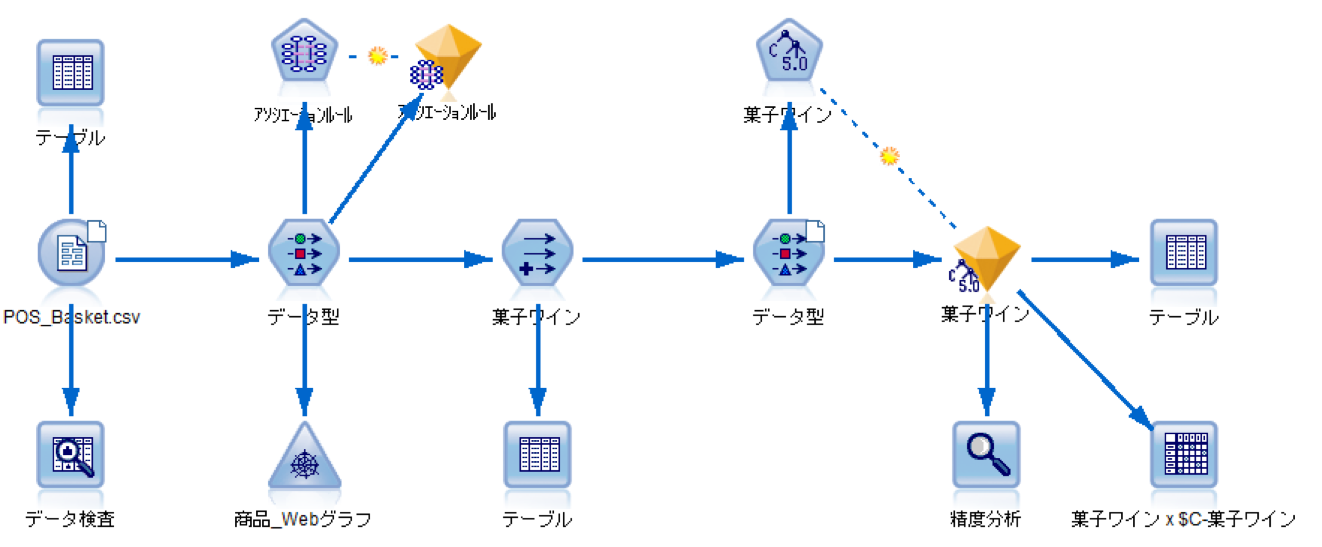
Modeler は、データの読み込みから加工、予測モデルの作成、評価、スコアリングまでを、ノードと呼ばれるアイコンを線でつないで組み立てるデータマイニングソフトウェアです。分析の流れが一枚の図として残るため、担当者が替わっても同じ手順を再現できます。
ご相談は製品に詳しい専門スタッフが承ります。IBM SPSS 正規販売店です。

SPSS Modeler とは
SPSS Modeler は、予測や分類のモデルを作り、業務の判断に組み込むためのデータマイニングソフトウェアです。1998年に「Clementine」の名で登場して以来、顧客分析、需要予測、品質管理、与信などに使われてきました。分析の手順を「ストリーム」として保存し、新しいデータに同じ処理を繰り返し適用できます。決定木、ニューラルネットワーク、クラスター分析、アソシエーション分析など、機械学習のアルゴリズムをコードを書かずに使えます。
- 主な用途
- 予測・分類・併売・異常検知
- 操作
- ノードをつなぐビジュアル操作
- 連携
- データベース・R・Python・Spark
- 主な手法
- 決定木・ニューラルネットワーク・クラスタリングほか
分析の流れが、そのまま画面になります
データマイニングには、課題の理解から業務への展開までの標準的な進め方があります。Modeler では、その各段階がノードとして画面に並びます。
データマイニングの考え方と CRISP-DM の進め方は データマイニングの解説(完全ガイド) にまとめています。
Modeler の特徴
分析の手順を、一枚のストリームに
データの入力、加工、モデル作成、グラフ、出力までをノードの連結で表します。どのデータに、どの順番で、どんな処理をしたかが一目で分かるため、チームでの確認や引き継ぎに向いています。
- コードを書かずに一連の処理を組める
- ストリームを保存して、翌月のデータにも同じ処理
- SQL へのプッシュバックでデータベース内で処理
複数のデータを、キーでつなぐ
CSV、Excel、リレーショナルデータベース、Hadoop などのデータを読み込み、顧客ID などのキーで結合できます。受注、会員、アンケートなど部署ごとに分かれたデータを、分析用の一つの表にまとめられます。
- 複数ファイルの結合・集計・派生項目の作成
- 欠損値や外れ値を自動で確認するデータ検査
- 気象データなど外部データとの組み合わせ

自動モデリング
複数のアルゴリズムで一度にモデルを作り、精度を比べて上位のモデルを残します。データの準備を自動で行う機能もあり、最初の見通しを短時間で得られます。
テキスト・地理空間の分析
問い合わせやレビューなどの文章から概念や評判を取り出し、数値データと合わせて分析します。緯度経度や住所を使った地理空間の分析にも対応します。
オープンソースとの連携
R や Python のコードをノードとして組み込めます。Spark や Hadoop と連携し、大きなデータの処理にも使えます。
業務での使われ方
顧客、製造、金融の3つの領域で、Modeler が使われている代表的な場面です。
離反防止・併売・新規獲得
解約しそうな顧客を事前に見つけて手を打つ離反予測、一緒に買われる商品を見つける併売分析、反応しやすい顧客を選ぶキャンペーン対象の抽出に。
小売・通信・サブスクリプション・金融
歩留まり改善・予知保全
製造条件と不良の関係を決定木で読み解く歩留まり改善、センサーデータから故障の兆候をとらえる予知保全、検査データの異常検知に。
製造・設備・インフラ
与信・不正検知
申込時の初期与信、利用状況にもとづく途上与信、通常と異なる取引を見つける不正検知やコンプライアンス対応に。
金融・保険・EC
目的別の主なアルゴリズム
| 目的 | 主なアルゴリズム・ノード |
|---|---|
| 分類・予測 | C5.0、CHAID、C&R Tree、QUEST、ランダムツリー、ロジスティック回帰、ニューラルネットワーク、SVM、ベイジアンネットワーク |
| 数値の予測 | 線型回帰、一般化線型モデル、回帰木、ニューラルネットワーク |
| セグメンテーション | K-Means、TwoStep、Kohonen |
| 併売・購買の順序 | Apriori、CARMA、シーケンス |
| 時系列 | 時系列モデル(指数平滑法・ARIMA) |
| 異常の検出 | 異常値検出 |
| 自動化 | 自動分類、自動数値、自動クラスタ、自動データ準備 |
エディションによって使えるノードが異なります。必要なアルゴリズムからエディションをご提案します。
エディションの選び方
| Professional | Premium | |
|---|---|---|
| 向いている使い方 | 構造化データでの予測・分類・セグメンテーション | 文章データや関係性の分析まで含めた活用 |
| データ準備・ストリーム作成 | ● | ● |
| 分類・予測・クラスタリング・併売 | ● | ● |
| 自動モデリング | ● | ● |
| テキスト分析 | - | ● |
| エンティティ分析・ソーシャルネットワーク分析 | - | ● |
エディション構成は IBM の製品体系の改定にあわせて変わることがあります。最新の構成でご案内します。
ご相談から活用まで
課題のヒアリング
予測したいこと、使えるデータ、社内の体制をうかがいます。
構成のご提案
エディション、ライセンス、必要に応じてサーバー配置をご提案します。
お見積り・導入
お見積りと稟議資料をお渡しし、ご注文後にライセンスを発行します。
立ち上げ支援
研修や分析支援で、最初のモデルが業務に乗るまでご一緒します。
購入前によくいただくご質問
プログラミングの経験がなくても使えますか。
はい。ノードを配置して線でつなぐ操作で、データの加工からモデル作成まで行えます。R や Python を使いたい方は、コードをノードとして組み込むこともできます。
SPSS Statistics との違いは何ですか。
Statistics は仮説を検定し、結果を報告するための統計解析ソフトです。Modeler は予測モデルを作り、新しいデータに当てはめて業務の判断に使うためのソフトです。両方を組み合わせて使う企業も多くあります。
どのくらいのデータ量を扱えますか。
PC 上での分析から、データベースやサーバーと連携した大規模データの処理まで対応します。データ量と利用人数をうかがって構成をご提案します。
試してから決めたいのですが。
まずは無料のオンライン相談で、お持ちの課題に合うかを一緒に確認します。デモのご案内もその際にご相談ください。
導入後の研修はありますか。
操作研修から、テーマを決めて一緒にモデルを作る伴走型の支援まで用意しています。
機械学習のモデルも作れますか。
はい。決定木(C5.0、CHAID、C&R Tree)、ニューラルネットワーク、サポートベクターマシン、Random Trees、XGBoost など、機械学習のアルゴリズムをノードとして使えます。複数のモデルを自動で作って精度を比べる自動モデリングのノードもあります。
SPSS Modeler の価格はどのように決まりますか。
エディション、ライセンス方式、契約期間の組み合わせでお見積りします。お見積りは無料です。利用目的とデータ量、利用人数をうかがって構成をご提案します。
Modeler の構成・お見積りのご相談
予測したいことと、お手元のデータの種類をお知らせください。エディションとライセンスの形、立ち上げの進め方まで含めてご提案します。
お電話でも承ります0120-835-761平日 9:00–18:00
セミナーのお知らせ