統計の日スペシャルセミナー2026
開催レポート
問いの立て方から、SPSS Statistics 32と新製品、生成AIと統計解析、エスティマンドまで。5つのセッションの要点をまとめました。
この日の要点
- 01研究の問いは「誰の」「何が起きている」「何と比べる」「何で測る」の4つの箱で仮説になる。午前のワークショップでは、参加者が自身のテーマで研究計画シートを1枚書き上げました。(セッション1)
- 02SPSS Statistics 32は媒介分析を標準搭載。あわせて新製品のLocalStats Studio(11月2日発売)、ブラウザで使うSmart Stats、Text Coder X for SPSS Ver.2(共起ネットワーク)を発表しました。(セッション2)
- 03AIがコードを書いても、結果の責任は人に残る。IBMのSowmya Kannan氏の講演は、仕様を先に固めて合意してから実装する「仕様駆動開発」を柱に据えました。(セッション3)
- 04アンケート分析は「読み込む・加工する・分析する・結果を作る」の4工程で約40分。ロジスティック回帰では全体の正解率に加えて分類表を確認します。(セッション4)
- 05エスティマンドは「何を推定したいか」を5つの要素で定める枠組み。川﨑洋平教授は、中間事象への対処方針の違いが同じ試験から異なる推定値を生むことを論文で示しました。(セッション5)
5分でわかる当日のハイライト
5つのセッションを5分にまとめたダイジェスト動画です。初公開した新製品3つの画面と、IBMからのビデオメッセージも収めています。
開催概要
10月18日は「統計の日」です。1870年(明治3年)のこの日に、近代的な生産統計の始まりとされる「府県物産表」に関する太政官布告が出たことにちなみ、1973年に定められました。当社はこの統計の日にあわせて、2022年から毎年スペシャルセミナーを開いています。5回目となる今年は10月23日に、ビジョンセンターグランデ東京浜松町(東京都港区)とオンライン(Zoomウェビナー)で開き、5つのセッションをお届けしました。
ソフトウェアを買っていただいたところから、皆さんの研究の旅が始まる。その旅に寄り添いたい。
開会のあいさつ 代表取締役 畠 慎一郎
| 開催名称 | 統計の日スペシャルセミナー2026 |
|---|---|
| 開催日時 | 2026年10月23日(金)10:00〜17:00 |
| 開催方法 | ハイブリッド開催(午前の部は会場のみ、午後の部は会場とオンライン) |
| 会場 | ビジョンセンターグランデ東京浜松町(東京都港区芝大門1-13-9 UD芝大門ビル)/Zoomウェビナー |
| 参加費 | 無料 |
| 併設イベント | 懇親会「KOWAZA Night」18:00〜(別会場) |
| 主催 | スマート・アナリティクス株式会社 |
| 募集ページ | 統計の日スペシャルセミナー2026(プログラム・登壇者) |
プログラム
- 10:00〜12:00会場のみセッション1 量的研究は怖くない!2026 問いを磨いて研究計画にする畠 慎一郎(スマート・アナリティクス)
- 13:30〜14:20
- 14:25〜15:00セッション3 生成AI×統計解析 グローバル最新事情 IBMの講演ビデオ(日本語字幕)Sowmya Kannan 氏(IBM)/日本アイ・ビー・エム株式会社
- 15:10〜16:00
- 16:10〜17:00セッション5 量的研究デザイン入門 「何を明らかにしたいか」を起点とした設計川﨑 洋平 教授(埼玉医科大学 医学部)
セッション1 10:00〜12:00 会場のみ
量的研究ワークショップ 問いを磨いて研究計画にする
午前の2時間は、会場の参加者に限定したワークショップ「量的研究は怖くない!2026 問いを磨いて研究計画にする」に充てました。講師は畠です。参加者は自身の研究テーマを持ち込み、講義とワークを交互に進めながら、研究計画シートを1枚書き上げました。
問いを4つの箱で仮説にする
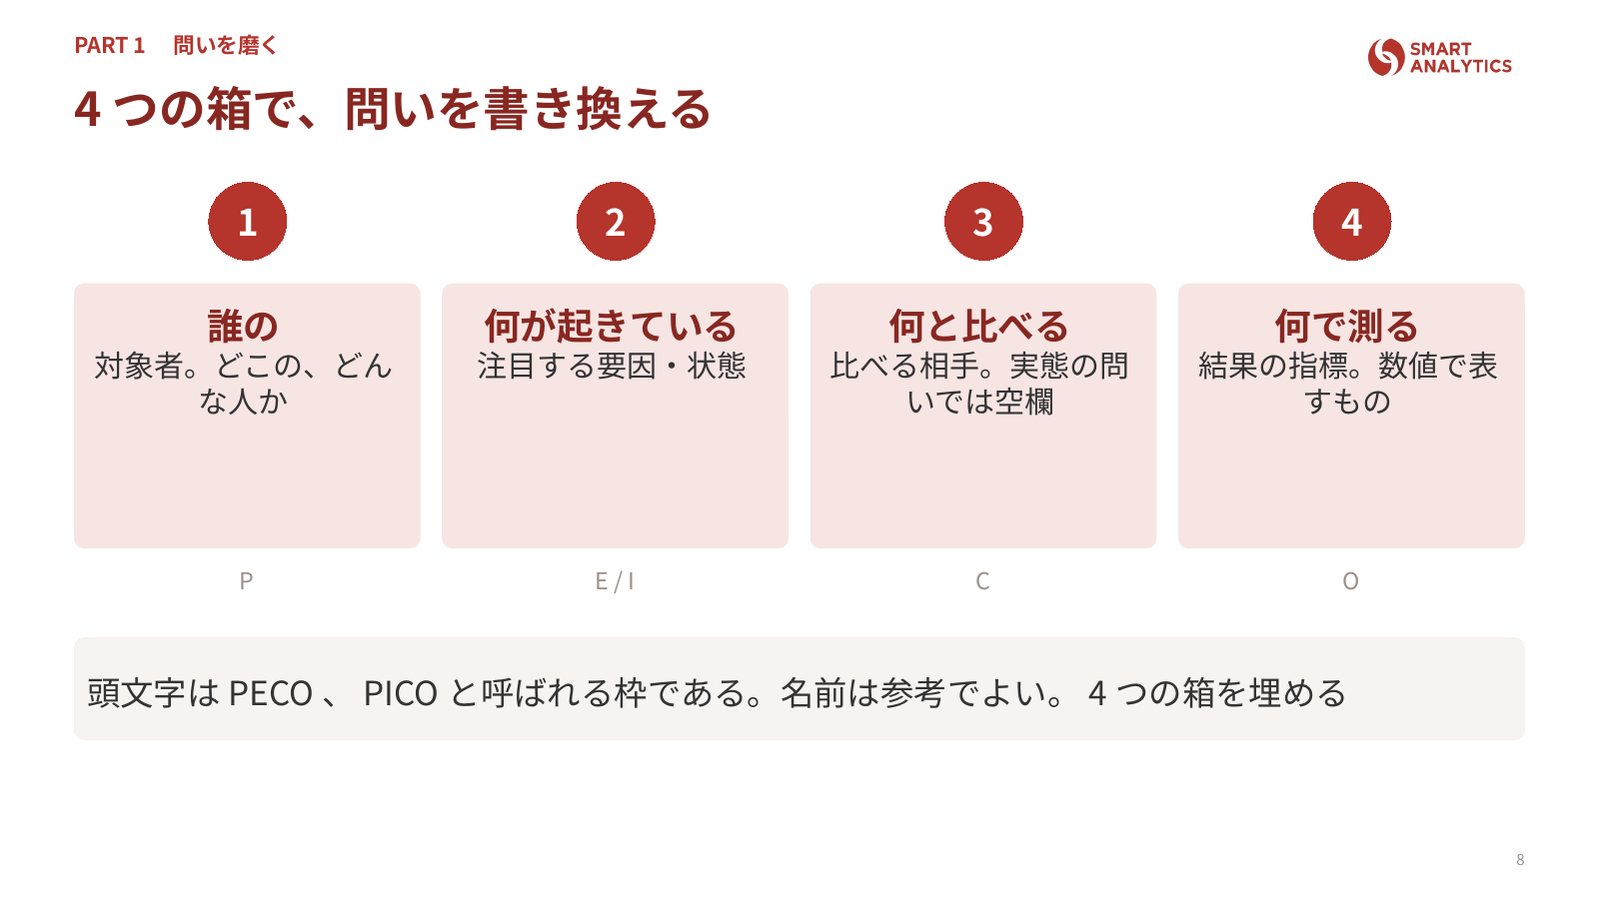
例題は、看護師の夜勤回数と職務満足の関係です。「夜勤回数と職務満足に関係はあるか」という問いを「誰の」「何が起きている」「何と比べる」「何で測る」の4つの箱に書き分けると、「1か月の夜勤回数が多い看護師ほど職務満足が低い」という、向きを持った仮説になります。枠組みとしてはPICO(PECO)にあたります。続いて、実現可能性や新規性、倫理面などを確かめるFINERの5項目で問いを点検しました。
概念図では、原因側のXと結果側のYに加え、結果に影響しうる調整要因を書き出します。夜勤の例では、経験年数、部署、時間外勤務時間がこれにあたります。畠は研究費の申請を例に挙げ、「申請書を出して3か月もたつと、頭の中の計画と書いたものがずれてくる。分析の前に概念図と照らし合わせてほしい」と話しました。
測定 尺度水準と信頼性・妥当性
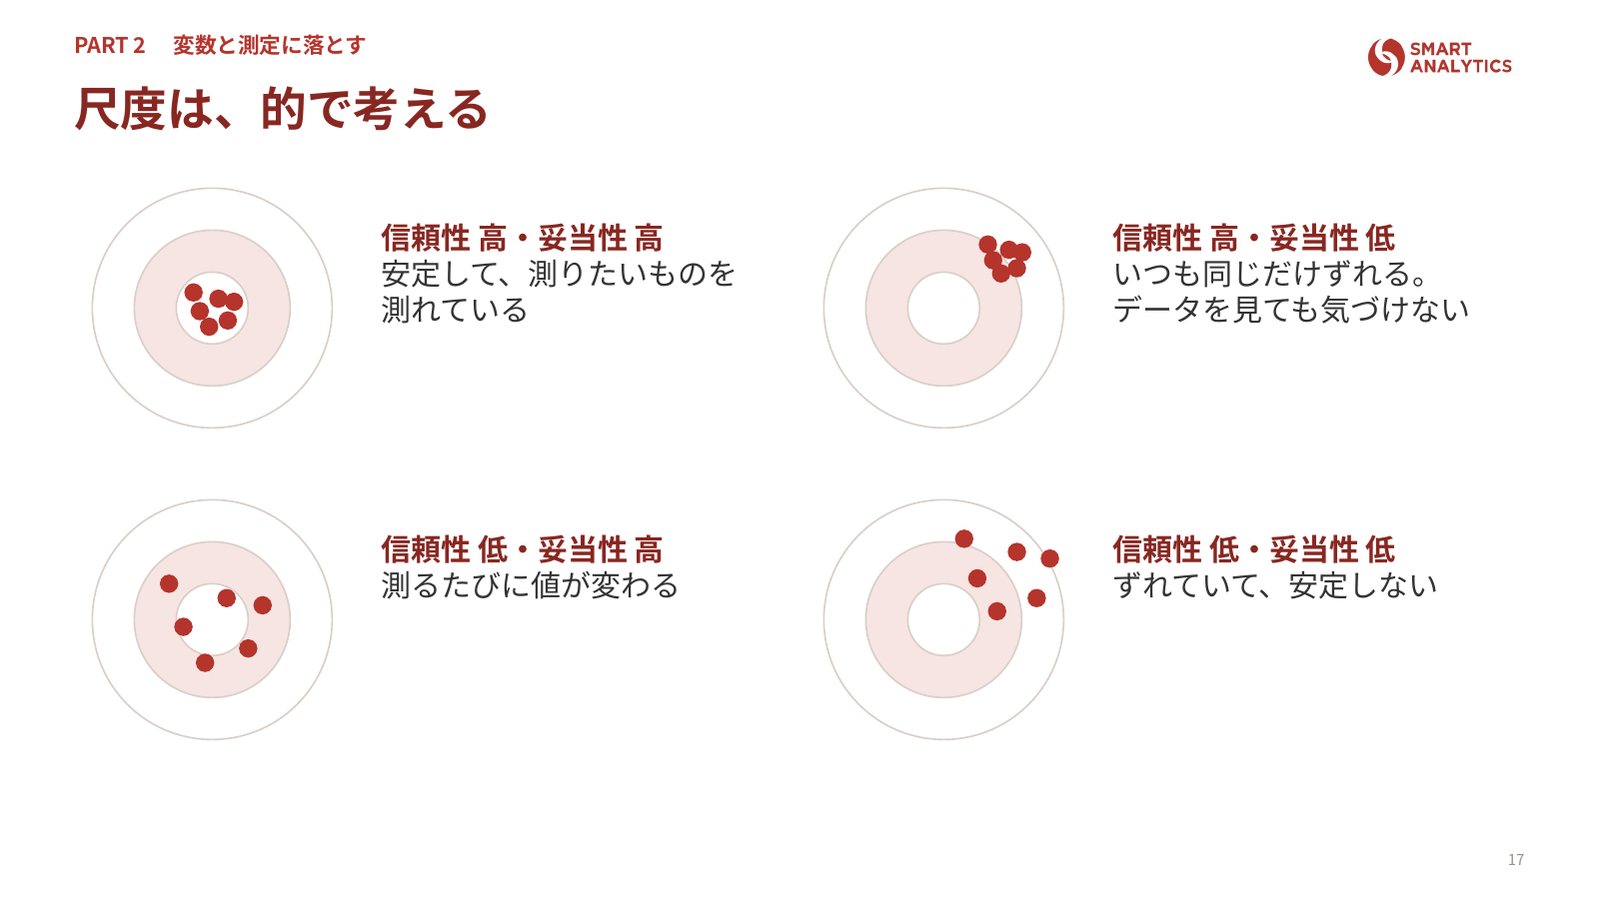
測定の話題では、比率・間隔・順序・名義の4つの尺度水準を確認しました。畠は「データは細かく取っておけば、後からまとめられる」として、収集の段階で情報量の多い形を選ぶよう勧めました。既存の尺度を翻訳して使う際の注意、信頼性と妥当性の違い、最近の発表で紹介された、Webパネル調査の回答の1割ほどにAIによる回答が混じっているという話題にも触れました。
分析方法の選び方とサンプルサイズ
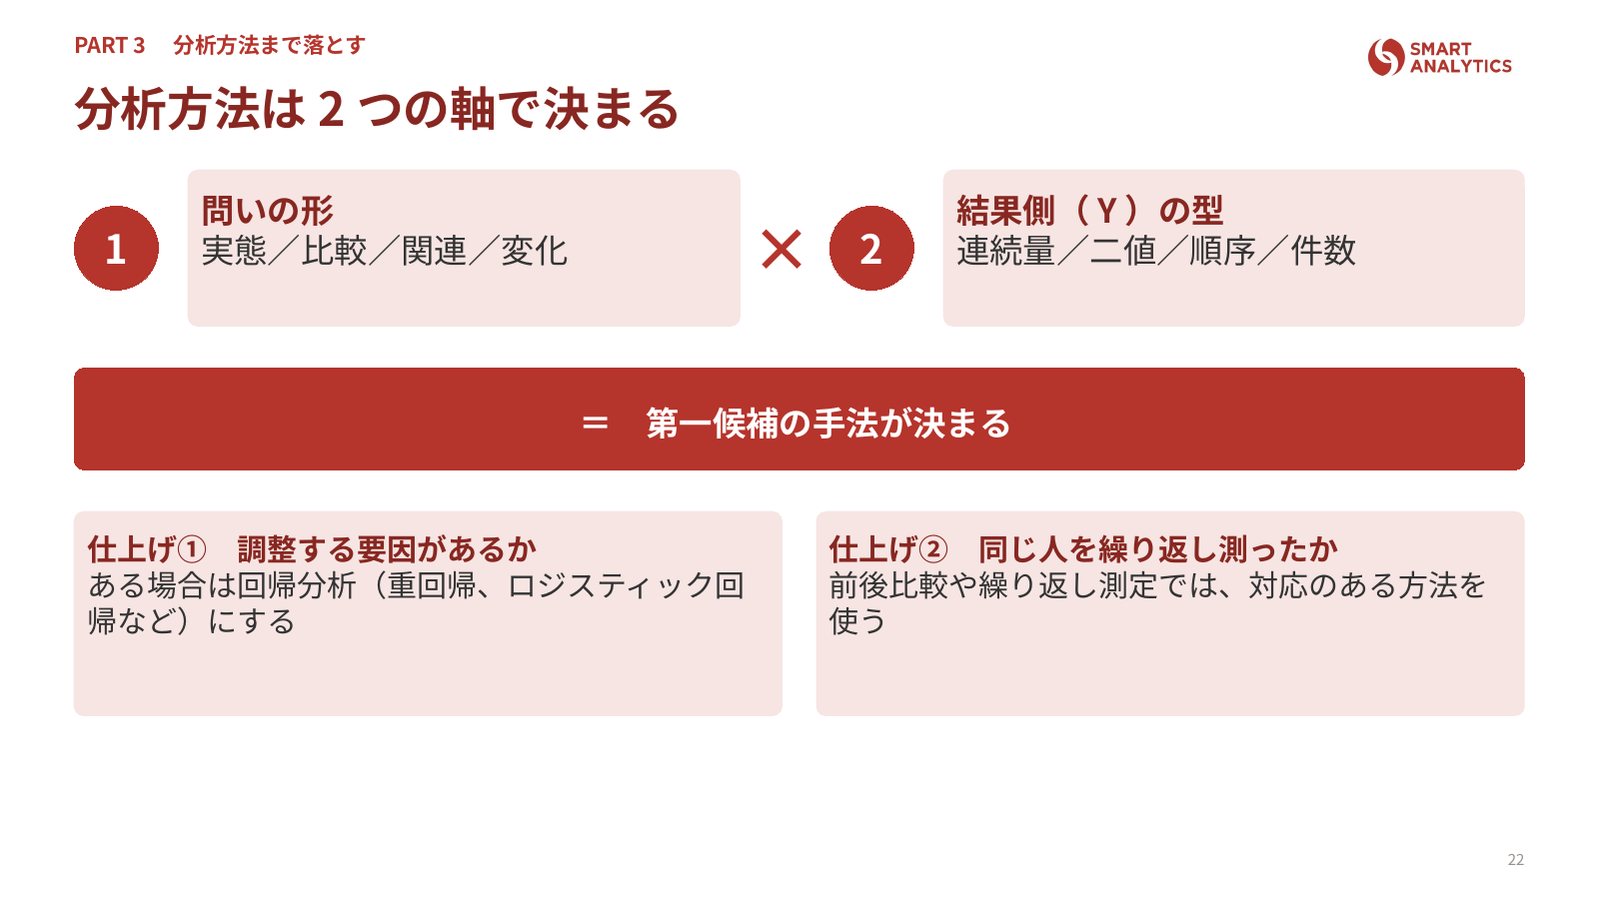
分析方法は、問いの形(実態・比較・関連・変化)と結果変数の型(連続量・二値・順序・件数)の組み合わせで第一候補が決まります。正規分布を仮定できる2群の平均の比較にはt検定、正規分布を仮定しにくい場合は順位で2群を比べるマン・ホイットニーのU検定が候補になります。畠は「分析手法は導かれる」と述べ、研究者がデータに合う式を求めて手法を作ってきたことが、手法の多さにつながっていると説明しました。例として、心疾患の危険因子を追った米国の長期研究から、結果が二値になるデータを扱うロジスティック回帰が広まった経緯を紹介しました。
後半はサンプルサイズを扱いました。有意水準、検出力、効果量の3つを決めれば必要な人数が求まり、効果量0.5、有意水準5%(両側)、検出力80%で2群を同数ずつ比べる場合、2群の合計で約128人(各群64人)になります。有意水準を5%と定めたうえで、p値が5.1%のときに「やや有意」と書く例を挙げ、事前に決めた基準で判断するよう求めました。最後に因子分析の結果の書き方の定型を示し、書いた計画シートを他の人に見せて「健全なツッコミ」をもらうことを宿題としました。
セッション2 13:30〜14:20
SPSS Statistics 32の新機能と新製品の発表
午後はオンライン配信を加えて再開しました。セッション「SPSS Statistics 最前線」では、畠がSPSS Statistics 32の新機能と、当社の新製品・新バージョンを紹介しました。
SPSS Statistics 32 媒介分析が標準機能に
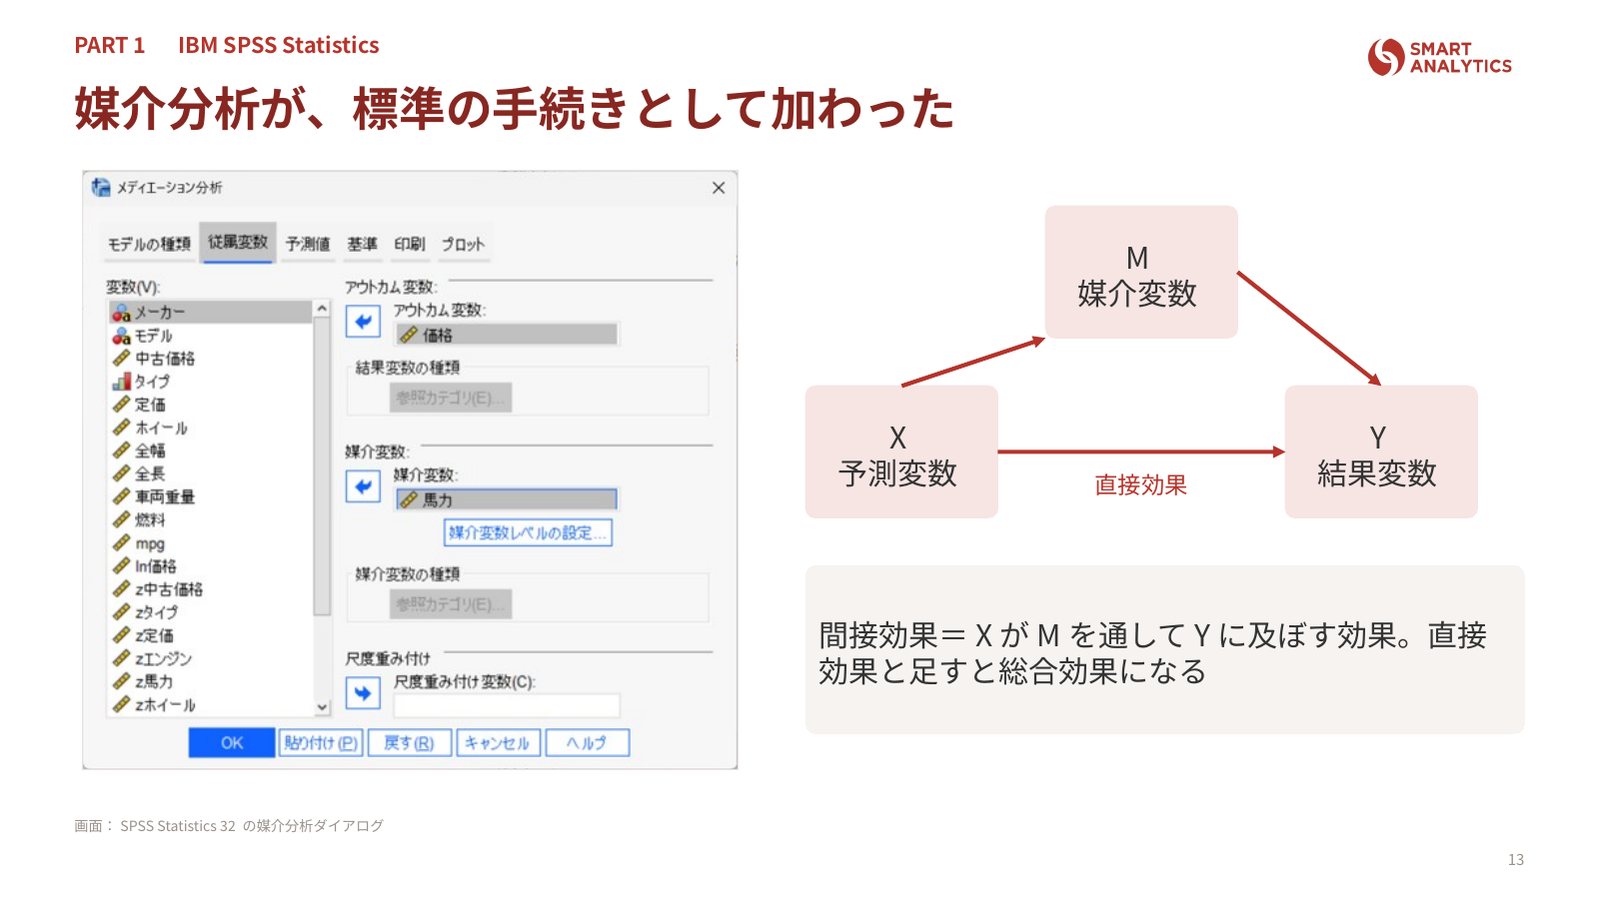
2026年4月に出たバージョン32の目玉は、媒介分析の標準搭載です。XがMを介してYに及ぼす間接効果の推定は、これまで海外の研究者が作ったPROCESSマクロで行うのが一般的でした。畠は、当社で両者を比較したところ計算方法が一部異なり、PROCESSマクロの結果とわずかに差が出たと説明しました。このほか、出力表の色分けと独自の解説の付与、複数の変数の時系列上の相互関係を扱うVARモデル、AIアシスタントを組織として無効にする設定が加わりました。
過去の版で加わった機能も振り返りました。31(2025年6月)は距離相関と条件付き推測ツリー、31.0.1は出力をAIが解説する機能と、多数の候補から有効な変数を選ぶBorutaによる変数選択。30はブランド・アルトマン分析、アンダーソン・ダーリング検定などを含む正規性の分析、ダークモード。29はLasso、Ridge、Elastic Net、バイオリンプロット、ROC曲線のYouden指数です。会場では検定力分析でサンプルサイズを求め、G*Powerと同じ値が出ることを示しました。
Text Coder X for SPSS Ver.2 共起ネットワークを追加
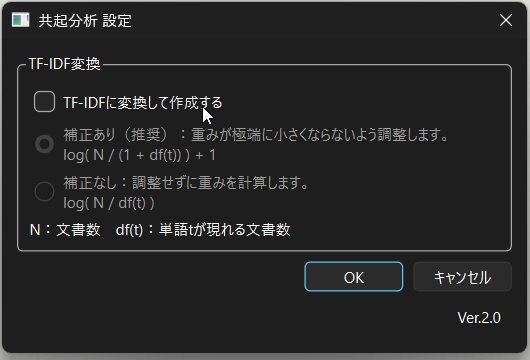
当社のSPSS拡張機能 Text Coder X for SPSSは、自由記述を単語に分け、出現回数や出現の有無(0/1)をSPSSのデータに変換します。Ver.2では「共起分析」タブを追加し、TF-IDFへの変換を選んだうえで、共起ネットワークをブラウザ上で操作しながら読めるようにしました。
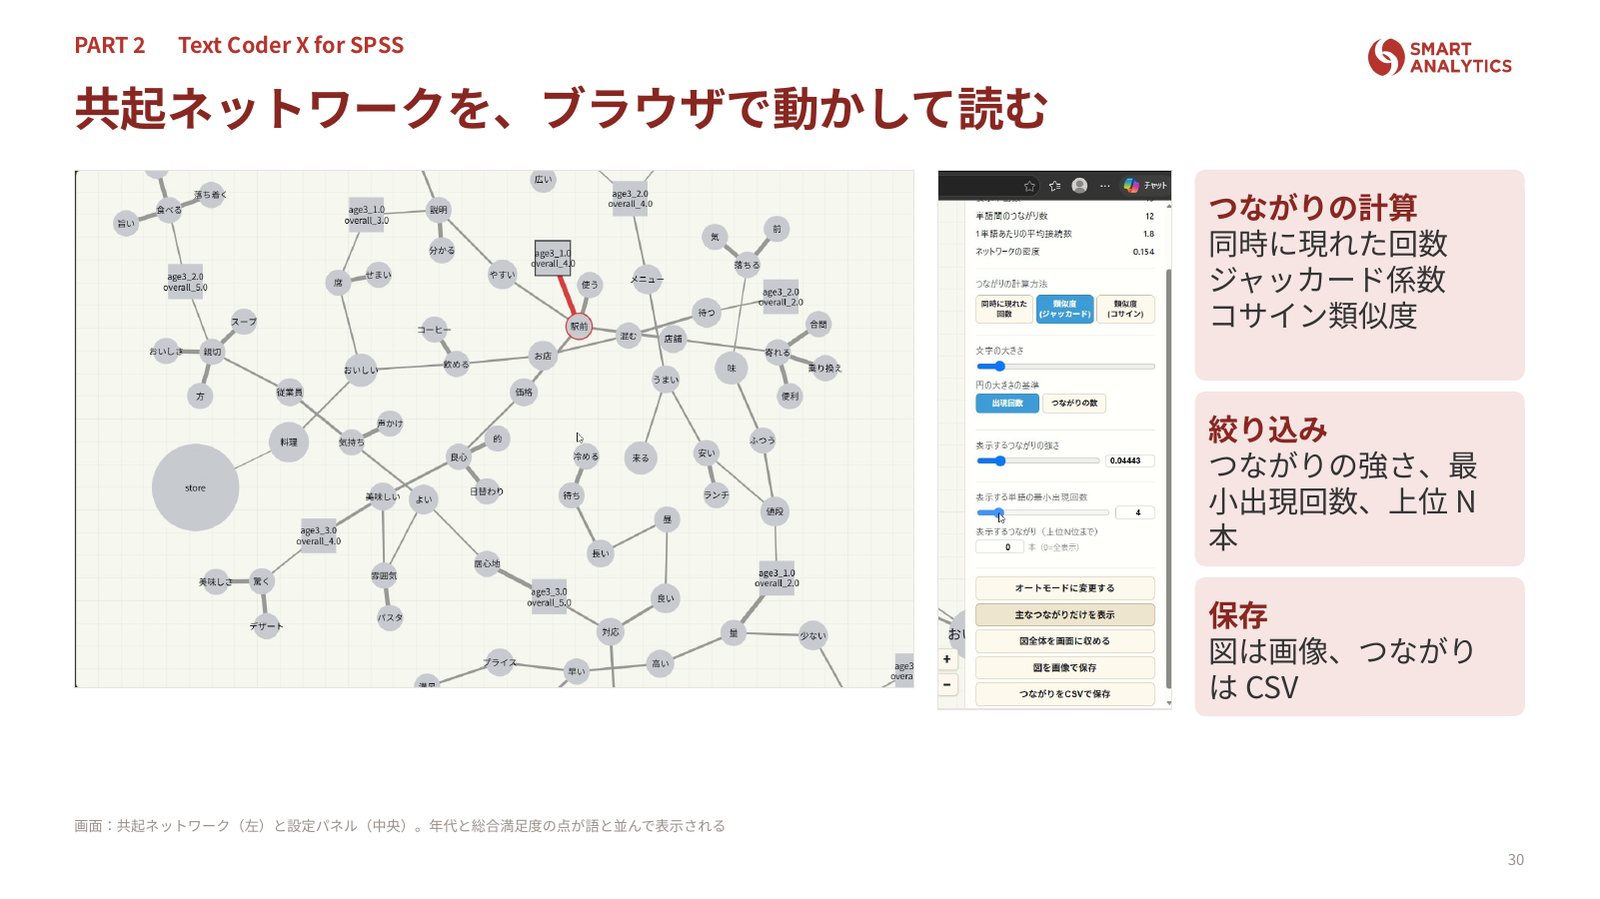
レストランのアンケートを使ったデモでは、「料理」と「美味しい」が太い線で結ばれました。つながりの強さのしきい値を変えて図を調整し、画像やCSVで保存できます。
LocalStats Studio SPSSの手元で動くAI分析支援(11月2日発売)
LocalStats StudioはSPSS Statisticsをお使いの方向けの新製品で、10月23日にプレスリリースを出し、11月2日に発売します。年に数回だけ分析する方から寄せられる「毎回メニューを確認し直す」「新しい手法の出力の読み方を知りたい」という声が、開発のきっかけになりました。
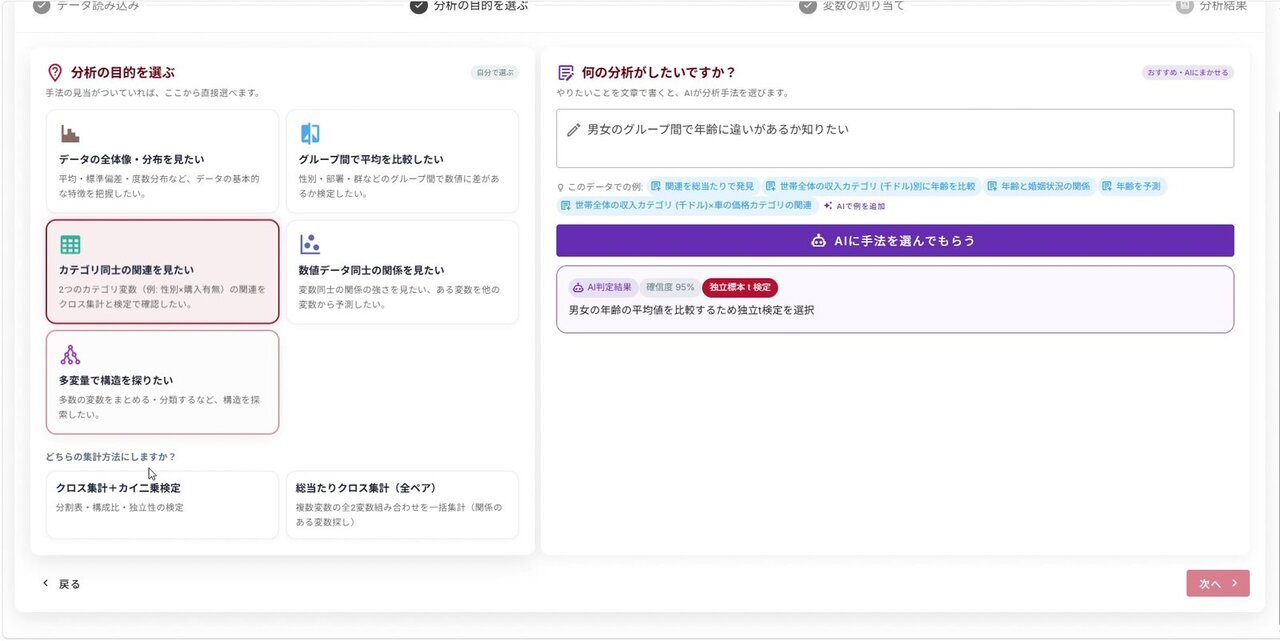
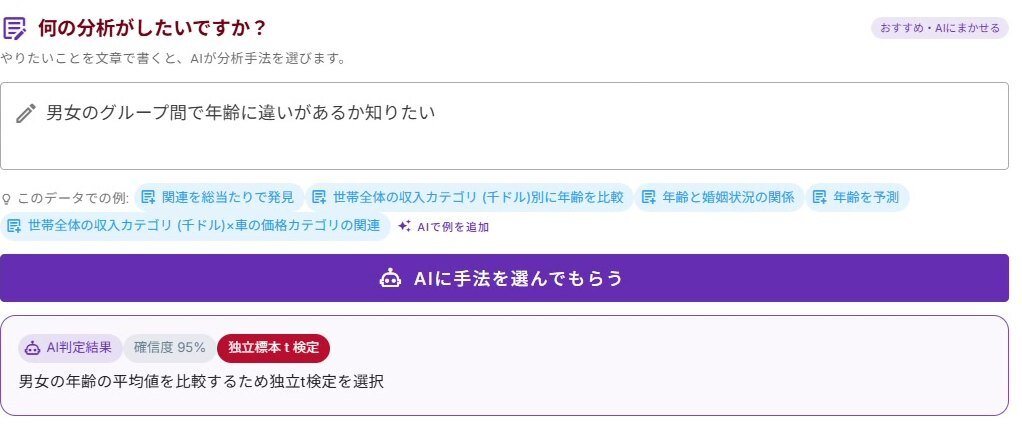
SPSSが入ったPCにインストールして使います。ガイドモードでは分析の目的から選び、「グループを比較する」「3群以上」と進むと一元配置分散分析を提示し、ノンパラメトリック手法にも切り替えられます。やりたいことを文章で入力すると、生成AIが手法を提案します。裏側でシンタックスを組み立て、手元のSPSSが計算するため、結果はSPSSの出力と一致します。個々の回答データは手元のPCにとどまり、AIに送るのは、入力した文章、変数名、分析結果です。
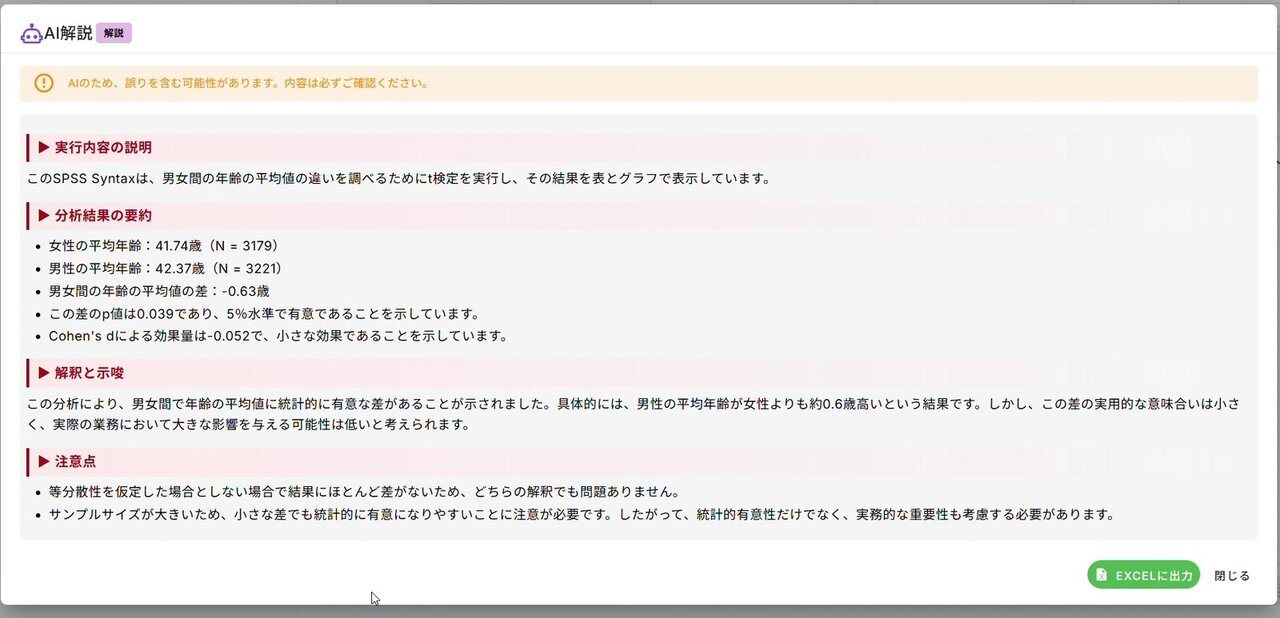
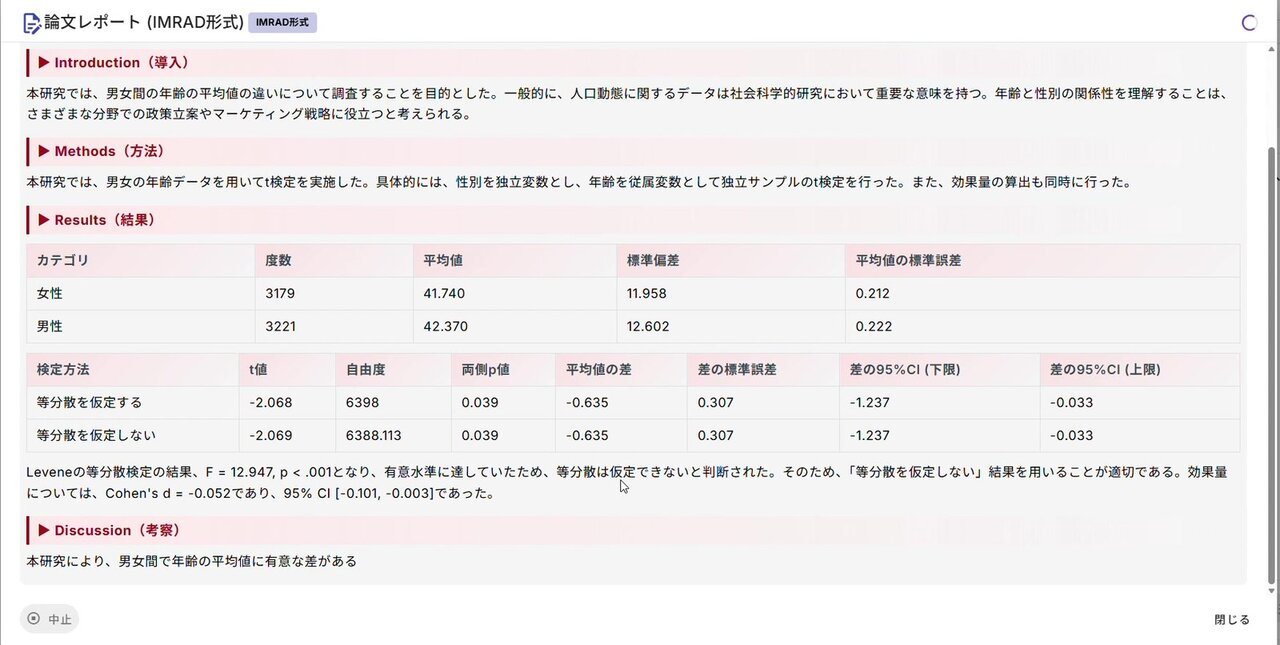
結果にはAIによる解説を付けられ、論文の「結果」の章にあたる文章を作ります。考察は研究者ご自身が書く前提です。表はExcelに書き出せます。Amosをお使いの方向けには、因子分析の結果からAmosのパス図を作る機能を備えています。性格特性(Big5)のデータを使ったデモでパターン行列からパス図を作り、畠は「これまでパス図を描くのに少なくとも2時間はかかっていた」と話しました。詳細モードでは、日本語で書いた処理をAIがシンタックスに変換して実行します。日常的にSPSSを使う当社のスタッフが改善したいと感じた点を形にした製品で、今後もデータ加工などの機能を加えていきます。
Smart Stats ブラウザで使う統計解析サービス
Smart Statsは、ブラウザで使うクラウド型の統計解析サービスです。畠はSPSS、IBM、Salesforceと海外製品を長く扱ってきた経歴に触れ、「いつか日本発で世界に出せる製品を作りたかった」と語りました。まず看護研究版と市場調査版を用意しました。CSVやExcelのデータを読み込むと変数のラベルをAIが提案し、研究の問いや目的に沿って分析の方針を決めます。
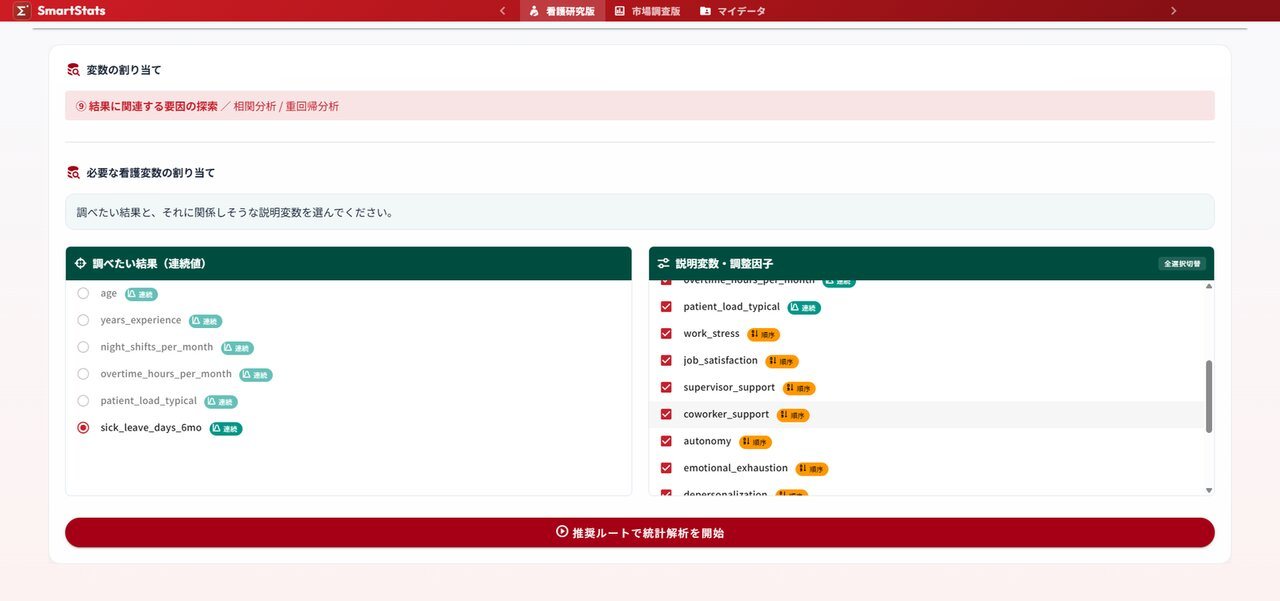
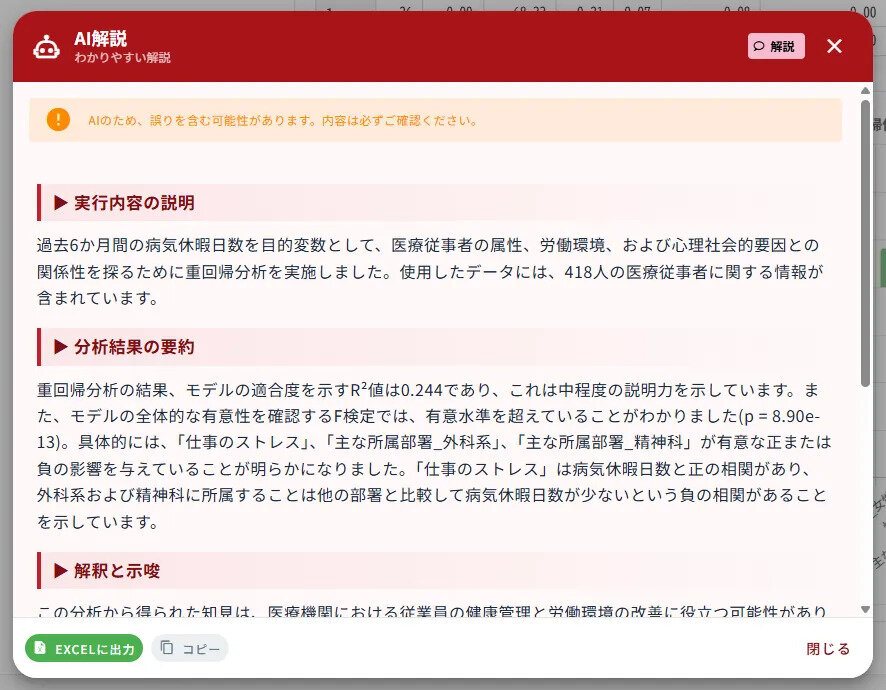
記述統計、t検定、カイ二乗検定、分散分析、クラスカル・ウォリス検定、重回帰分析、ロジスティック回帰分析、決定木などに対応し、市場調査版はキャンペーン反応の分析も備えています。SPSSを導入する前の臨床の看護師の方や、初めてデータを扱う方が、ガイドに沿って分析できるよう設計しました。より高度な分析にはSPSS Statisticsをお勧めする位置づけで、プレスリリースは翌週に出す予定です。
セッション3 14:25〜15:00
生成AIと統計解析 IBMの講演ビデオ(日本語字幕)
セッション「生成AI×統計解析 グローバル最新事情」では、IBMで教育・人材育成部門のディレクターを務めるSowmya Kannan氏の講演「Universities: Teaching Students to Build Responsibly with AI」を上映しました。日本IBMの許可を得て、当社が日本語の字幕とスライドを付けたものです。
上映に先立ち、畠がIBMのAI開発ツール「IBM Bob」を紹介しました。大学での使い方として、演習でe-Statなどからデータを取得する作業、実習の様子を撮影した動画による評価、SPSSの出力の解説、学生が自ら考えたアプリを作るアクティブラーニングを挙げました。データ分析の手順であるCRISP-DMと、ソフトウェア開発の手法との共通点にも触れました。
問題の定め方と設計に重点を移す
Kannan氏は、AIがコードの多くを書く時代の大学教育について語りました。プログラミングの基礎を残しながら、問題の定め方とシステム設計に重点を移す。学生には設計の選択を説明させ、アプリが要件を満たすことを示させる。家の増築を例に、部屋を1つ足すにも、動線や配管、元の構造との関係に設計者が答える必要があると説明しました。
仕様駆動開発 書いて、合意してから実装する
講演の柱は、開発前に詳細な仕様を書き、関係者と合意してから実装に入る「仕様駆動開発」です。予約アプリを例に、「1つの枠は1人の客だけが予約できる」「予約は24時間前まで取り消せる」といった業務ルール、「枠が予約されたら、他の利用者には埋まったと表示される」という受け入れ条件、決済やカレンダー連携を第2版以降に回す範囲の決め方を示しました。IBM BobはAsk、Plan、Agent、Advancedの各モードで作業を進める仕組みで、コードを書く前にPlanで設計を固め、各段階で人が確認します。
終盤には1970年代のIBMの資料の一節を引き、成果に最終的な責任を負うのはリーダーだと述べました。コーディングをエージェントに任せても、責任は人に残るという考え方です。最後に、IBM SkillsBuildの学習教材と、学生がAIを使ったアプリを作る「AI Builders Challenge」(7月はクリエイティブ産業、8月は宇宙探査がテーマ)を紹介しました。
任せても、結果の責任は人が持つ。統計解析も同じ。
上映後のコメント 畠 慎一郎
研究と教育でのBobの使い方を参加者と一緒に試すワークショップを開く予定です。ご希望の方はアンケートかメールでお申し込みいただけます。
セッション4 15:10〜16:00
アンケートデータ分析の実演 読み込みから報告用の表まで約40分
セッション「実践!アンケートデータ分析を一挙公開」では、畠がSPSS Statisticsを操作し、1つのデータを読み込みから報告用の表の作成まで約40分で処理しました。
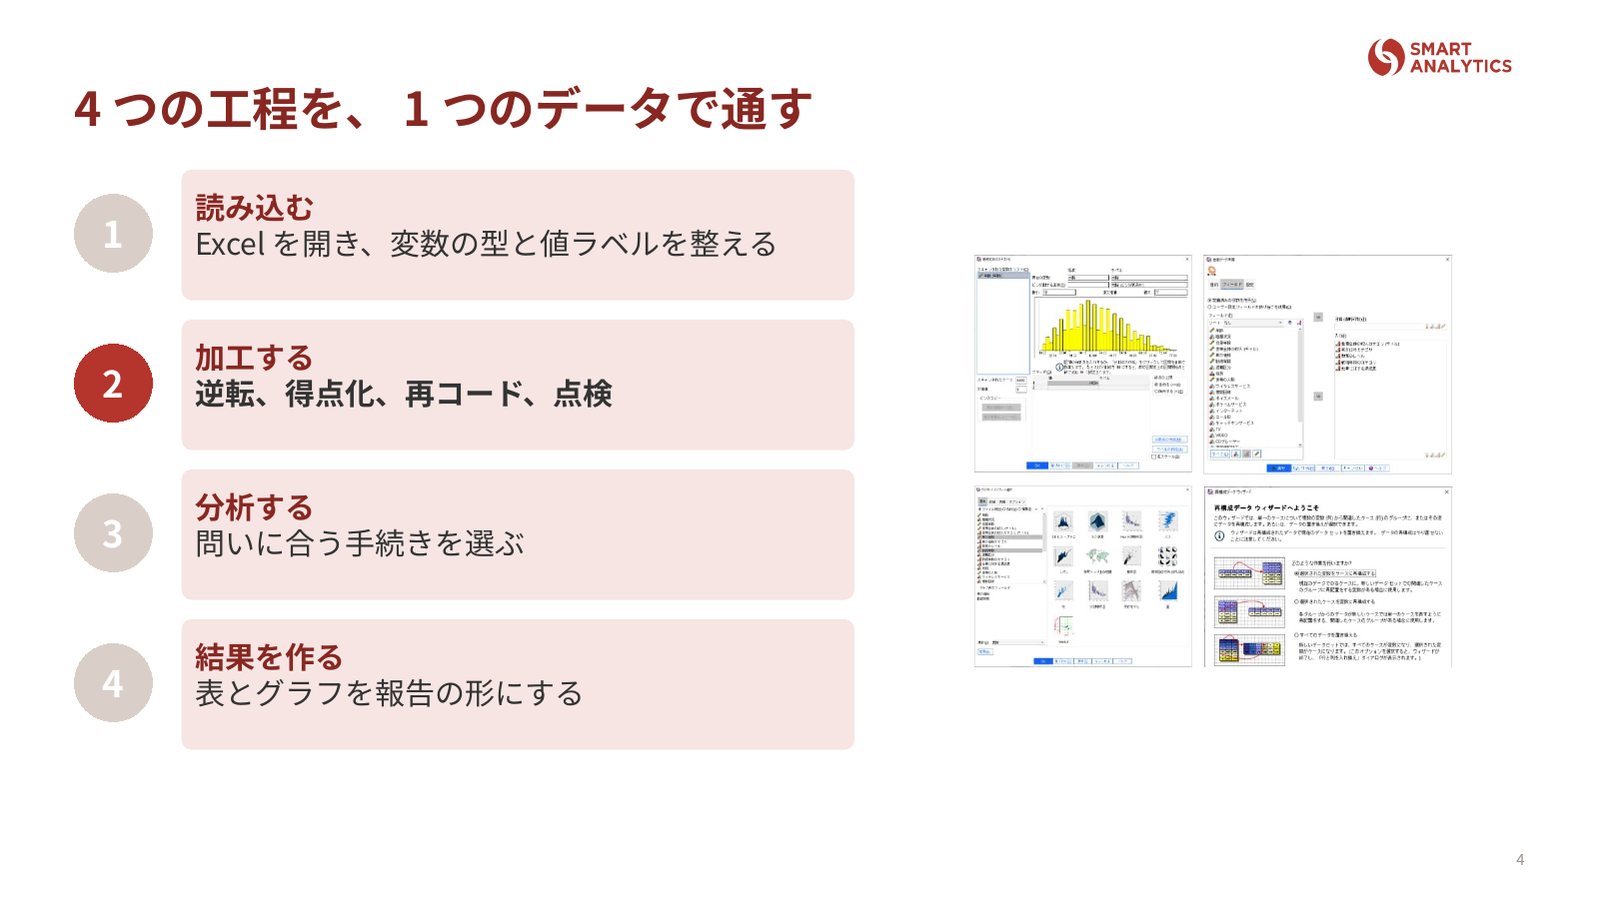
題材は「心理的安全性が高い職場で働く人ほど、離職意向は低いか」です。病院の看護職と企業の社員、計300名の架空データを使いました。午前の4つの箱に当てはめると、誰の=職場で働く人、何が起きている=心理的安全性の高さ、何と比べる=心理的安全性が低い職場、何で測る=1年以内に職場を辞めたいと思うか、となります。
読み込む 変数名とデータの型を整える
Excelでは1行目に変数名を置くのが基本ですが、SPSS Statistics 32からは読み込みを始める行を指定できます。変数名は短くし、先頭は文字にして、区切りにはアンダーバーを使います。設問番号をQ1のように簡潔にしておくと、後でシンタックスを書くときに扱いやすくなります。読み込んだ後は変数ビューを整えます。性別の「F/M」のような文字列は「連続数への再割り当て」で1と2に置き換え、ラベルも同時に付けます。欠損値99の指定と尺度の設定もこの段階で済ませます。変数の属性をまとめてコピーし、他の変数に貼り付ける小技も紹介しました。
加工する 範囲外の値、逆転項目、尺度得点
変数をまとめて選び、右クリックで記述統計を出すと、全体を一度に点検できます。ここで5件法の項目に「44」と「6」という範囲外の値が見つかり、欠損として処理しました。逆転項目の2問は「他の変数への値の再割り当て」で1を5、2を4のように入れ替えた新しい変数を作りました。心理的安全性の5項目の信頼性係数(クロンバックのα)は0.89です。「変数の計算」のMEAN関数で平均点を作り、離職意向(5件法)の4と5を「あり」とするフラグを作りました。300人のおよそ3分の1が「辞めたい」と答えています。一連の操作は、ダイアログの「貼り付け」ボタンでシンタックスとして残せます。畠は「LocalStats Studioは、このコードを書いて実行している」と、セッション2で発表した製品との関係を説明しました。
分析する t検定からロジスティック回帰へ
離職意向の有無で心理的安全性の平均点を比べるt検定では、「あり」の群が2.6、「なし」の群が3.3でした。等分散性の検定でp=0.036となり等分散が棄却されたため、ウェルチの検定の行を読み、p<0.001で差を確認しました。続いて、性別と年代をカテゴリ変数に指定した二項ロジスティック回帰に進みました。
畠が「見落としがち」と念を押したのが分類表です。離職意向「なし」と予測して当たった人が163名、「あり」と予測して当たった人が41名で、全体の正解率は69.9%でした。一方で、離職意向「あり」と答えた人のうち61名を「なし」と予測しており、「あり」の人を正しく予測できた割合は40.2%です。「なし」の人を「あり」と予測した数は27名です。発症が100人中5人のようなデータでは、全員を「発症なし」と予測しても95%当たるため、分類表を必ず確認するよう勧めました。論文にはExp(B)、すなわちオッズ比と95%信頼区間を記し、区間に1が含まれるかを確かめます。実演のモデルには、心理的安全性の5項目と、経験年数、先月の時間外勤務、年代、性別を投入しました。心理的安全性の5項目のオッズ比は0.81〜0.84で、いずれも1を下回りましたが、95%信頼区間はすべて1をまたいでいました。
結果を作る 論文向きの表と自由記述の可視化
出力表はピボットテーブルの「Academic」スタイルにすると、論文向きの簡素な体裁になります。英語で論文を書く場合は、出力の言語を英語に切り替えられます。自由記述はText Coder Xで共起ネットワークにし、「夜勤明け」「申し送り」などの語のつながりを読みました。グラフは、SPSSの出力をExcelに移して作るか、生成AIに描かせる方法を勧めました。
畠は「目的が分かっていれば、手法はある程度限られる」と述べ、紙のまま保管されているデータの入力から研究の支援まで承っていることを案内しました。
セッション5 16:10〜17:00
量的研究デザイン入門 エスティマンドで「何を推定したいか」を定める 川﨑洋平教授
最後のセッション「量的研究デザイン入門」には、埼玉医科大学医学部の川﨑洋平教授に、学内の会議の合間にオンラインでご登壇いただきました。川﨑教授の専門は生物統計学とベイズ統計学で、臨床試験の設計と解析に携わっています。テーマは、研究で推定したい効果を具体的に定める「エスティマンド」です。
川﨑教授はまず、糖尿病の臨床試験の論文を示しました。同じ試験、同じ群、同じ評価項目(HbA1c)について、主要な結果として「マイナス0.9ポイント」と「マイナス1.2ポイント」の2つの値が載っています。
3つのE エスティマンド・推定量・推定値
- エスティマンド(推定対象)
- 研究の目的に照らして推定したい効果を、具体的に定めたもの。
- 推定量(エスティメーター)
- エスティマンドに対応する解析の手順。
- 推定値(エスティメート)
- 推定量をデータに適用して算出される数値。
川﨑教授は、この「3つのE」をこの順に考えるよう説き、「〇〇検定を使いたい」という手法の側から研究を組み立てる例が多いと指摘しました。
エスティマンドの5要素と中間事象
エスティマンドは、比較する治療、対象集団、評価する変数、中間事象への対処方針、集団レベルの要約の5要素で構成されます。治療、対象集団、変数は広く使われるPICOと共通する要素です。エスティマンドではそこに、効果を集団レベルでどう要約するかと、中間事象をどう扱うかを加えて、問いを具体的に定めます。川﨑教授は「今日は『問いに対する中間事象』という言葉さえ覚えていただければ十分です」と話しました。
中間事象は、治療の開始後に起き、結果の解釈に影響する出来事を指します。副作用や効果不十分による治療の中止、追加の薬剤、治療の切り替えなどです。川﨑教授は、中間事象と欠測(観察するはずだった値が欠けていること)を区別するよう強調しました。薬を中止した後も通院を続け、26週目のデータがそろった人は「中間事象あり・欠測なし」、中止後のデータが欠けた人は「中間事象あり・欠測あり」となります。
対処方針(ストラテジー)が推定値を決める
対処方針には、中止や切り替えの後も観察を続けてその値を使う「治療方針ストラテジー」、当初の治療がそのまま続いた場合を想定する「仮想ストラテジー」、中止を失敗として評価項目に組み込む「複合変数ストラテジー」、服薬中の値だけを使う「治療下ストラテジー」などがあります。どれを選ぶかは、服薬中の効果を知りたいのか、中止後も含めた治療の過程全体の結果を知りたいのかという、研究の問いによって決まります。
冒頭の論文の2つの値は、この対処方針の違いによるものでした。マイナス0.9は治療方針として採用した場合の効果を問う治療方針ストラテジー、マイナス1.2は試験薬だけを続けた場合の効果を問う仮想ストラテジーによる推定値で、論文は2つの問いにそれぞれのエスティマンドを立てていました。
いずれの方針でも推定には仮定が伴うため、仮定を変えても結論が保たれるかを感度分析で確かめます。研究計画書には、研究目的を1〜2文で明記したうえで、エスティマンドの各要素、想定される中間事象と対処方針、その臨床的な理由、中間事象後の追跡方針、主解析・感度分析・補足的解析を記載します。この考え方は治験の国際ガイドラインICH E9(R1)で整理されたもので、川﨑教授は観察研究を含む幅広い研究で取り入れるよう呼びかけました。川﨑教授は機能性表示食品の臨床試験のあり方を検討する委員会の委員も務め、エスティマンドを食品の臨床試験に応用する論文を、大学と企業の研究者と共同で『薬理と治療』に発表されています。
当社では、エスティマンドを掘り下げるトレーニングを2027年3月上旬に開く予定です。
閉会とご参加の皆さまへ
閉会のあいさつで畠は、「学会とも学校とも異なる立場から、学際的に、産学をまたいでデータ分析を進めていきたい」と述べました。セミナーの後は、18時から別会場で懇親会「KOWAZA Night」を開きました。
240名のお申し込みをいただき、ありがとうございました。朝から会場に足を運んでくださった皆さま、オンラインでご参加くださった皆さまに、心より感謝申し上げます。講演ビデオの上映と日本語化をご快諾くださった日本アイ・ビー・エム株式会社様とSowmya Kannan様、会議の合間を縫ってご登壇くださった川﨑洋平教授に、厚くお礼申し上げます。
今後の予定
- 毎月SPSS小技Live(SPSS小技セミナー) オンライン・無料
- 11月20日KOWAZA Night 大阪
- 日程調整中IBM Bob ワークショップ 研究と教育での使い方を参加者と一緒に試します
- 2027年3月上旬エスティマンドのトレーニング
LocalStats Studio、Smart Stats、Text Coder X Ver.2のデモと試用のご希望も受け付けています。
研究計画の無料相談(30分)
セッション1の研究計画シートの書き方、サンプルサイズの決め方、分析手法の選択、新製品のデモと試用について、オンラインでご相談いただけます。